
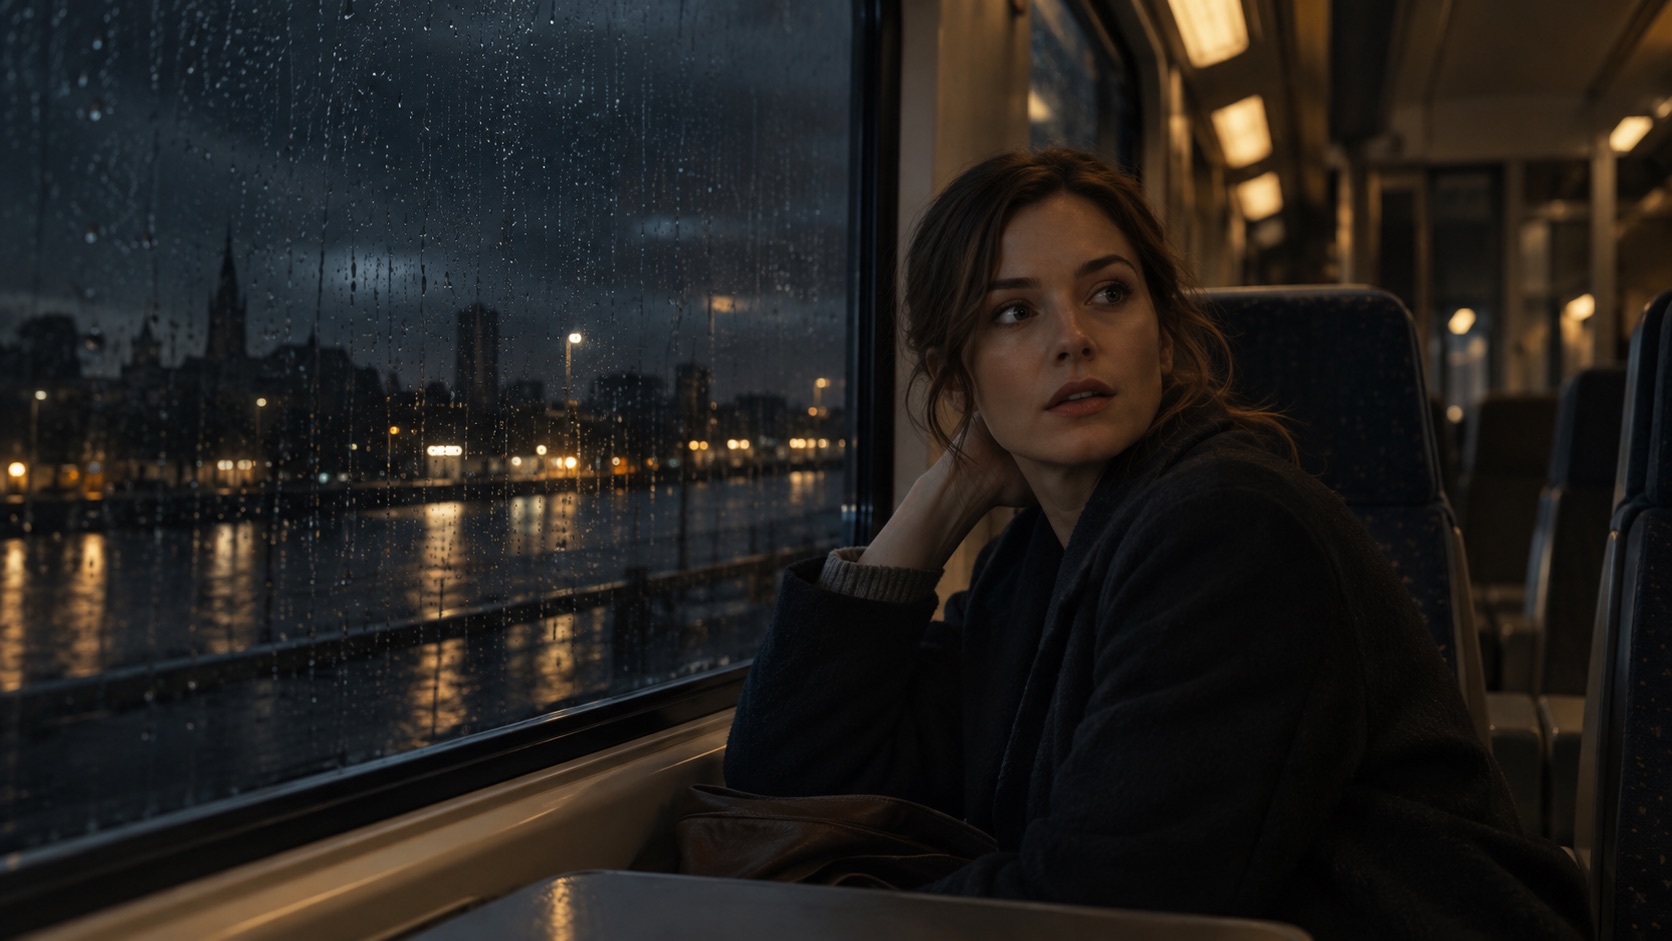
Eine Frau sitzt nachts in einem leeren Zug. Regen läuft über die Scheibe. Sie blickt auf, als hätte jemand ihren Namen gesagt. Die Kamera fährt langsam näher.
Ein paar Sätze reichen, um eine solche Einstellung anzufordern. Niemand muss einen Zug mieten, Regen erzeugen oder eine Kamera auf Schienen stellen. Trotzdem kann das Ergebnis aussehen, als wäre genau das passiert.
Das wirkt wie ein technischer Zaubertrick. Und führt zu einer naheliegenden Frage: Wie macht die KI das eigentlich?
Die Antwort beginnt mit einer Unterscheidung. Denn das Modell, das einen Dialog schreibt, und das Modell, das die Frau im Zug sichtbar macht, erfüllen unterschiedliche Aufgaben.
1. Ein Sprachmodell ist noch kein Videomodell
LLM steht für „Large Language Model“, also großes Sprachmodell. Solche Modelle lernen beim grundlegenden Training, aus einem vorhandenen Text die nächsten Textbausteine vorherzusagen. Diese sogenannten Tokens können Wörter, Wortteile oder einzelne Zeichen sein.
Dabei entstehen Fähigkeiten, die weit über einfache Satzergänzungen hinausgehen: Fragen beantworten, Texte strukturieren, Dialoge entwerfen oder Anweisungen verarbeiten. Das Prinzip der schrittweisen Textfortsetzung bleibt für klassische generative Sprachmodelle grundlegend.
Im Filmworkflow kann ein LLM deshalb aus einer Idee eine Szenenbeschreibung machen, Einstellungen vorschlagen oder einen unklaren Prompt präzisieren. Die bewegten Bilder entstehen jedoch häufig in einem eigenen Videomodell. Dass beides über dasselbe Eingabefeld erreichbar ist, macht daraus noch nicht denselben technischen Vorgang. Im Sora-Forschungsbericht beschreibt OpenAI beispielsweise, wie GPT kurze Eingaben ausführlicher formuliert, bevor sie an das Videomodell gehen.
2. Was das Modell beim Training lernt
Ein Videomodell bekommt während des Trainings große Mengen an Bild- und Videomaterial. Bei textgesteuerten Systemen spielen dazugehörige Beschreibungen eine wichtige Rolle. Das Modell lernt Zusammenhänge zwischen Sprache und sichtbaren Vorgängen: Wie verändert sich ein Gesicht beim Drehen? Wie bewegen sich Spiegelungen? Was unterscheidet eine Kamerafahrt von einer Person, die auf die Kamera zugeht?
Dabei werden sehr viele Zahlenwerte im Modell angepasst. Sie bestimmen später, welche visuellen Strukturen unter welchen Bedingungen entstehen. Der technische Bericht zum offenen Videomodell Wan beschreibt unter anderem die Aufbereitung großer Bild- und Videobestände sowie skalierbare Trainingsstrategien.
Für die Filmszene ist das entscheidend: „Nächtlicher Zug“ ruft ein ganzes Bündel gelernter Zusammenhänge auf. Dunkle Fenster, künstliches Innenlicht, vorbeiziehende Helligkeit, möglicherweise Spiegelungen im Glas. Was davon in unserer Einstellung auftauchen soll, haben wir mit diesen zwei Wörtern noch lange nicht vollständig entschieden.
3. Wie aus Rauschen ein Bild entsteht
Ein wichtiger Ansatz der Bildgenerierung heißt Diffusion. Vereinfacht lernt ein Modell dabei, schrittweise hinzugefügtes Rauschen wieder zu entfernen. Bei der Generierung beginnt der Prozess mit zufälligem Rauschen und formt daraus in mehreren Rechenschritten eine Bildstruktur, die zur Eingabe passt.
Man kann sich das wie ein Bild vorstellen, das sich langsam aus Fernsehschnee herausarbeitet. Allerdings liegt darunter kein fertiges Foto, das nur freigelegt werden müsste. Das Ergebnis entsteht erst durch den Rechenprozess.
Häufig passiert das in einem komprimierten mathematischen Raum, dem „latenten Raum“. Dort muss das Modell weniger Daten verarbeiten als bei der direkten Berechnung sämtlicher Bildpunkte. Anschließend wird diese Darstellung in ein sichtbares Bild übersetzt. Das Grundprinzip erläutert die Forschung zu Latent Diffusion. Verwandte Verfahren wie Flow Matching lernen ebenfalls einen Weg von Rauschen zu strukturierten Daten, unterscheiden sich aber mathematisch. Die konkrete Technik variiert also zwischen Modellen.
4. Warum Video mehr braucht als schöne Einzelbilder
Für unsere Frau im Zug reicht ein überzeugendes Portrait nicht aus. Ihr Gesicht muss auch während der Bewegung erhalten bleiben. Die Scheibe muss an derselben Stelle sitzen. Die Spiegelung muss zur Perspektive passen.
Video verlangt Zusammenhänge über die Zeit. Ein dokumentierter Ansatz zerlegt die komprimierte Videodarstellung deshalb in kleine räumlich-zeitliche Einheiten. Das Modell verarbeitet also Informationen darüber, was sich an unterschiedlichen Stellen und zu unterschiedlichen Zeitpunkten ereignet. Sora wurde 2024 als ein solches System beschrieben.
Dabei begegnet uns ein Begriff, der auch bei LLMs auftaucht: Transformer. Diese Architektur kann Beziehungen zwischen Teilen einer Eingabe gewichten. Bei Sprache hilft das etwa, zusammengehörige Textstellen aufeinander zu beziehen. Sie ist aber nicht auf Sprache beschränkt. Ihre Grundlage beschreibt die Arbeit Attention Is All You Need. Die gemeinsame Architektur erklärt einen Teil der Verwandtschaft. Sie bedeutet nicht, dass ein Videomodell seinen Film einfach Wort für Wort schreibt.
5. Warum die Szene trotzdem falsch werden kann
Stellen wir uns vor, die Frau hebt eine Tasse. In der nächsten Sekunde verschmilzt der Henkel mit ihren Fingern. Danach steht die Tasse wieder auf dem Tisch, obwohl sie nie abgestellt wurde.
Das Licht stimmt. Die Stimmung stimmt. Die Handlung stimmt nicht.
Solche Fehler zeigen den Abstand zwischen überzeugender Erscheinung und verlässlicher physikalischer Konsistenz. Der Sora-Bericht benennt Schwierigkeiten mit Objektzuständen und grundlegenden Interaktionen. Für die Beurteilung einer Einstellung ergeben sich daraus zwei getrennte Fragen: Sieht dieser Moment glaubwürdig aus? Und bleibt der Vorgang über seine gesamte Dauer nachvollziehbar?
Wenn die Tasse ein wichtiges Requisit ist, wird ihr Verschwinden zum Anschlussfehler. Wenn das Publikum auf den Blick der Figur achten soll, kann schon eine kleine Verformung die Aufmerksamkeit an die falsche Stelle ziehen.
6. Was ein besserer Prompt tatsächlich verbessert
„Eine traurige Frau im Zug“ lässt viel offen. Weint sie? Starrt sie aus dem Fenster? Ist sie erschöpft, enttäuscht oder erleichtert?
Für die Inszenierung hilft es, die sichtbare Handlung zu bestimmen: Eine Frau sitzt regungslos am Zugfenster. Ihr Blick bleibt zunächst draußen. Dann hebt sie langsam die Augen zur Spiegelung in der Scheibe. Die Kamera nähert sich währenddessen nur leicht.
Diese Beschreibung macht die beabsichtigte Einstellung überprüfbarer. Wir können später erkennen, ob Blickrichtung, Bewegung und Kamera zusammenpassen. Das ist eine praktische Konsequenz für die Regie: Vor der Generierung festlegen, welches Ereignis der Shot tragen soll. Zusätzliche Adjektive ersetzen diese Entscheidung nicht.
Ebenso sinnvoll ist eine klare Priorität. Muss vor allem das Gesicht stimmen? Die Bewegung? Der Raum? Wenn alles gleichzeitig anspruchsvoll wird, lohnt es sich, die Einstellung neu zu planen.
Ein brauchbarer Prompt muss nicht lang sein. Er sollte aber klar festlegen, wer zu sehen ist, wo die Szene spielt, was in der Einstellung passiert und welche Bewegung tatsächlich wichtig ist. Das folgende Beispiel ist bewusst gekürzt und strukturiert:
Ein solches Briefing verbessert vor allem die Kontrollierbarkeit: Blickrichtung, Kamerabewegung und Ton sind als überprüfbare Entscheidungen benannt. Eine beiliegende Bildreferenz darf dabei nur verwendet werden, wenn ihre Rechte geklärt sind.
7. Wo aus Generierung Filmemachen wird
Kehren wir zur Frau im Zug zurück. Vielleicht liefert das Modell eine wunderschöne Einstellung. Aber ihr Blick hebt sich zu früh. Vielleicht stimmt die Bewegung, doch die Kamera kommt ihr zu nahe. Vielleicht erzählt eine fast regungslose Variante mehr als die ursprünglich geplante Fahrt.
Welche Fassung funktioniert, entscheidet sich im Zusammenhang mit dem Film. Was haben wir unmittelbar davor gesehen? Erwarten wir eine Begegnung? Hören wir tatsächlich eine Stimme? Bleibt die Einstellung lange genug stehen, damit aus einem Blick eine Frage wird?
Die Technik erklärt, wie das Material entstehen kann. Seine Bedeutung entsteht durch Auswahl, Dauer, Montage und Ton. Wer die Funktionsweise der Modelle versteht, kann ihre Ergebnisse genauer beurteilen. Man erkennt eher, wann eine Beschreibung unklar war, wann ein Ablauf zu viel verlangt und wann eine andere Einstellung die Geschichte besser tragen würde.
Die Frau im Zug wurde berechnet. Warum wir mit ihr warten, muss der Film erzählen.